
 | ||||||||||||||||||||||||||||||||||
Navigation • Home
| Was bedeutet der UTF-8 Zeichensatz?
Ein Foto in Ihrer Galerie trägt die Beschreibung „Blick über den Möhnesee“. Das sind 23 Zeichen. Auf der Festplatte des Servers belegt der Text aber 25 Byte, weil „ü“ und „ö“ je zwei Byte brauchen. Die Regel, wie aus Zeichen Bytes werden, legt der UTF-8-Zeichensatz fest. Sie ist der Grund, warum Umlaute, Eurozeichen und Emojis auf derselben Seite nebeneinander stehen können, und auch der Grund, warum aus einem „ü“ manchmal ein „ü“ wird. Wer die Rechnung einmal verstanden hat, liest Fehlermeldungen und Datenbankgrenzen mit anderen Augen.
Was der UTF-8-Zeichensatz mit Bytes machtHinter UTF-8 stecken zwei Schritte. Zuerst gibt der Standard Unicode jedem Zeichen der Welt eine feste Nummer: Das große A hat die Nummer 65, das „ü“ die 252, das Eurozeichen 8364 und das Kamera-Emoji 128247. UTF-8 legt dann fest, wie diese Nummer als Folge von Bytes gespeichert wird. Kleine Nummern kommen mit einem Byte aus, große brauchen bis zu vier. Genau genommen ist UTF-8 deshalb kein Zeichensatz, sondern eine Kodierung: Den Vorrat an Zeichen liefert Unicode, UTF-8 ist die Vorschrift, wie man ihn in Bytes schreibt. Im Alltag verschwimmt der Unterschied. Editoren, HTML (
Am ersten Byte erkennt ein Programm, wie lang das Zeichen ist. Dafür gibt es feste Bereiche: Ein Byte von Wie die vier Gruppen im Speicher aussehen, zeigt das Diagramm. Die Bytes eines Zeichens erscheinen dort nacheinander, so wie ein Programm sie liest. Die Balken rechts zeigen, bis zu welcher Zeile ein Zeichensatz reicht: Was darunter liegt, kann er nicht speichern. ISO-8859-1 und MySQL-latin1 stehen dort getrennt, weil sie sich genau beim Eurozeichen unterscheiden. 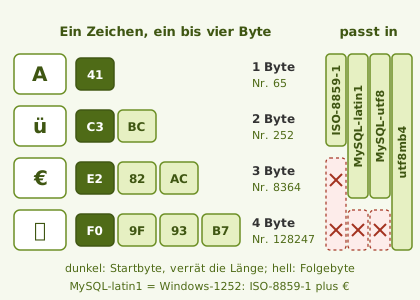 Zeichen sind nicht Bytes: was daraus folgtFür den Galeriebetrieb folgt aus dieser Bauweise vor allem eins: Länge in Zeichen und Größe in Byte sind zwei verschiedene Zahlen. „Sonnenuntergang am Strand“ hat 25 Zeichen und 25 Byte, denn darin steht kein einziger Umlaut. „Grüße aus Würzburg“ hat 18 Zeichen, aber 21 Byte. Eine Beschreibung aus 500 Zeichen belegt also irgendwo zwischen 500 Byte, wenn sie nur aus einfachen Buchstaben besteht, und 2.000 Byte, wenn sie ausschließlich aus Emojis bestünde. Programme, die Byte zählen statt Zeichen, schneiden Texte mit Umlauten deshalb früher ab, oder schlimmer: mitten in einem Zeichen. Dann bleibt ein einzelnes Auch Datenbanken rechnen an einer Stelle in Byte statt in Zeichen, nämlich beim Index. Was das für die Galerie bedeutet, steht weiter unten beim Schlüssel der Tabelle Warum der UTF-8-Zeichensatz latin1 abgelöst hatDer ältere Zeichensatz latin1, genauer ISO-8859-1, kennt genau 256 Zeichen, jedes ein Byte. Deutsch passt hinein, das Eurozeichen nicht, denn die Norm ist älter als der Euro. Microsoft hat das Eurozeichen in seiner Variante Windows-1252 auf einen frei gebliebenen Platz gesetzt, das Byte Genau das nutzen viele Programme bei Dateinamen. Ein Name wie Das BOM: drei Bytes, die niemand siehtEinige Editoren schreiben an den Anfang einer UTF-8-Datei die Bytes Wenn Umlaute falsch ankommenUTF-8 funktioniert nur, wenn Schreiber und Leser sich einig sind. Gibt eine Seite die Kopfzeile Der UTF-8-Zeichensatz im Bildergalerie-ScriptSeit Version 3.15 ist UTF-8 an jeder Stelle der Kette fest eingestellt, vom Server bis zur Datenbank. Die Übersicht zeigt, wo das jeweils geschieht und ob Sie selbst etwas tun müssen.
Tabellen: utf8mb4 oder latin1Eine Galerie, die aus einer älteren Version aktualisiert wurde, behält ihre Tabellen im Zeichensatz latin1. Das ist kein Fehler. Weil die Verbindung mit utf8mb4 arbeitet, wandelt MySQL beim Schreiben und Lesen selbst um, und die Umlaute kommen richtig an. Auch das Eurozeichen hat dort Platz, denn MySQL-latin1 ist Windows-1252. Nur Zeichen, die darin fehlen, etwa Emojis oder ein polnisches „ń“, lassen sich nicht speichern. Welchen Stand Ihre Tabellen haben, zeigt phpMyAdmin in der Tabellenübersicht in der Spalte „Kollation“. Dateinamen und der Schlüssel mit 190 ZeichenDamit derselbe Dateiname in einer Kategorie nicht zweimal vorkommt, hat die Tabelle Das Script nimmt deshalb nur die ersten 190 Zeichen des Dateinamens in den Schlüssel auf, in der Tabellendefinition steht Die Dateinamen selbst enthalten ohnehin keine Umlaute. Beim Hochladen schreibt die Galerie „ü“ als „ue“ aus und setzt alles klein. Namen, die ein Windows-FTP-Programm im alten Zeichensatz schickt, wandelt sie vorher nach UTF-8 um, und zerlegte Umlaute aus macOS setzt sie wieder zu einem Zeichen zusammen. Längengrenzen zählen Zeichen, nicht BytesEine Bildbeschreibung darf höchstens 500 Zeichen lang sein, und „Größenvergleich“ zählt dabei als 15, obwohl es 17 Byte belegt. Ist ein Text länger, kürzt das Script ihn auf genau 500 Zeichen und trennt dabei kein „ö“ in der Mitte durch. Dasselbe gilt für das Passwort der Verwaltung: Es braucht mindestens 8 Zeichen, und „Bärhöhle“ erfüllt die Regel mit genau 8 Zeichen, obwohl es 10 Byte lang ist. Beim Speichern prüft die Galerie außerdem, ob eine Beschreibung gültiges UTF-8 ist. Text im älteren Windows-Zeichensatz wandelt sie um, statt ihn zu verwerfen. Steuerzeichen und Zeilenumbrüche ersetzt sie durch Leerzeichen. In Häufige FragenDiese vier Fragen kommen beim Einrichten und bei der Fehlersuche am häufigsten. Welche Meta-Angabe gehört für den UTF-8-Zeichensatz in den Seitenkopf?
Warum reicht es nicht, nur die HTML-Seite auf UTF-8 zu stellen?Die Meta-Angabe sagt dem Browser nur, wie er lesen soll. Ob die Bytes, die er bekommt, wirklich UTF-8 sind, entscheiden andere: der Editor beim Speichern der Vorlage, die Verbindung zur Datenbank beim Auslesen der Beschreibungen. Bei mysqli legt Was ist der Unterschied zwischen utf8 und utf8mb4 in der Datenbank?Der Zeichensatz, den MySQL lange „utf8“ nannte, speichert höchstens drei Byte pro Zeichen. Umlaute und Eurozeichen passen hinein, Emojis mit ihren vier Byte nicht. utf8mb4 ist das vollständige UTF-8, „mb4“ steht für bis zu vier Byte. Für neue Tabellen ist utf8mb4 die richtige Wahl, das alte utf8 gilt in MySQL inzwischen als veraltet. Kann ich $sChartSet in der Galerie auf ISO-8859-1 umstellen?Das bewirkt nichts. Die Variable steht in Verwandte ThemenDamit UTF-8 von der Datei bis zum Browser durchgehend stimmt, helfen diese Artikel beim Einrichten und bei hartnäckigen Zeichenfehlern. | |||||||||||||||||||||||||||||||||
